从零开始实现ddpm
Haoran Qian · 收录于
最近期末月,同时也被ddpm的繁琐的数学推导搞得有点头大,理解了但是感觉写出来这篇文档还是很耗时的。。。最后磨蹭半天终于准备写一下。
数学原理:
ddpm总体分为两个过程,分别是前向传播和反向传播的过程。前向传播是一个加噪的过程,而反向传播是一个去噪的过程。
前向传播:
这里首先我们要知道一张图x_0,是满足高斯采样的,,而后面在t的时间步里面生成的图片我们记为x_t,那么,我们加噪的过程化成公式就是:
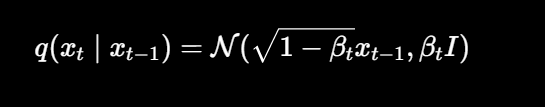
这里β_t很小,基本上是从10的负四次方到0.02,接下来我们引入α_t = 1 - β_t,所以形式上我们得到:
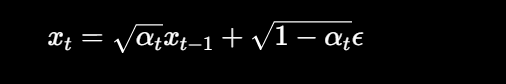
这里epsilon是我们引入的随机噪声,满足N(0,I)高斯分布,所以x_t依然满足高斯分布。
由于这显然很像一个马尔科夫链,所以我们可以得到x_0到x_t的公式,
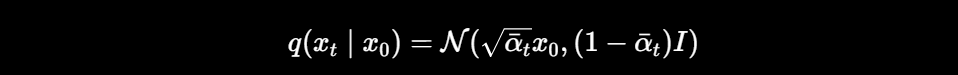
其中αˉt=α1α2⋯αt,浅显一点就是,xt=保留比例×x0+噪声比例×ϵ,当t很大的时候,第一项趋近于0,第二项趋近于1,可以认为是纯噪声。
反向传播:
反向传播就是和前向传播相反的过程,但是不同的是,这里需要模型进行预测(前向基本用于训练,反向用于采样),这里预测的只有一个噪声,原因会在后续的公式说明。
在前向里面对应的公式变成了
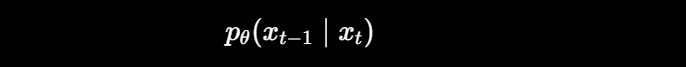
DDPM:假设反向也是高斯分布,同时会固定方差,让网络预测均值。
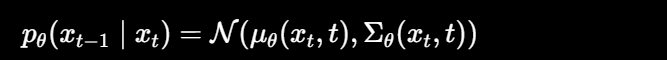
所以神经网络学的是预测均值。
这里说了预测均值,为什么之前又说预测噪声呢,是因为:
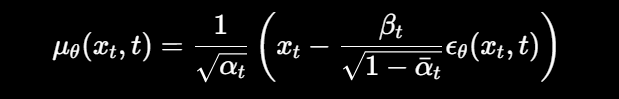
预测噪声自然会有均值。
这样之后我们看一下采样的过程,主要是这个公式:
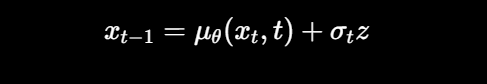
这个z是一个随机在噪声,在t=1的时候不加,加噪是为了保证多样性。
现在完整推导这个过程:
先准备两个已知分布:
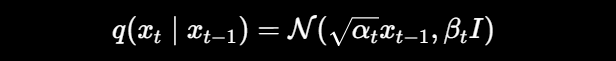
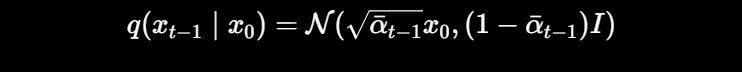
然后用贝叶斯公式:
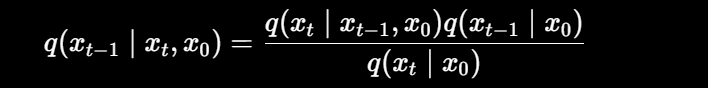
即:
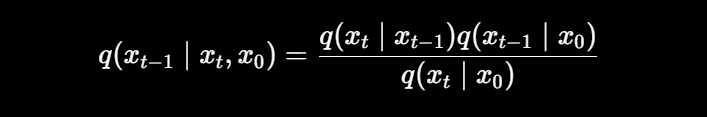
其中分母和x_t-1无关(最后作为归一化常数),而分子显然还是高斯分布。
然后我们处理分子,化简分子可得:
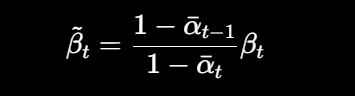
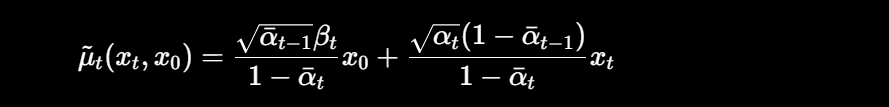
但是这个时候我们x_0是不知道的,但是由于
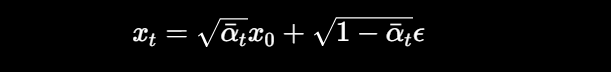
故我们预测噪声,是为了利用这个公式(用预测噪声替代真实的):
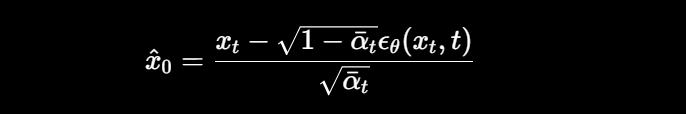
所以把这个x_0回代有
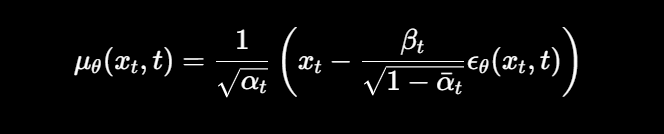
好的数学原理到这里就结束了,下面开始写代码了。
总体框架:
首先我们来看一下大体的架构,这里的ddpm是基于unet实现的,
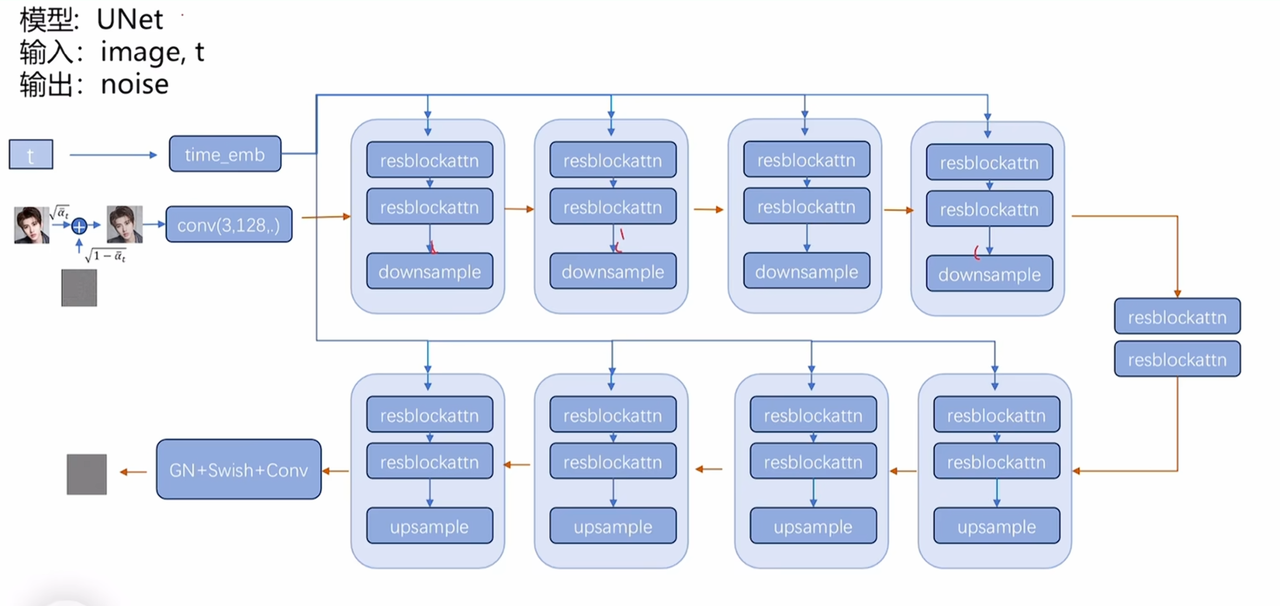
代码实现:
1.首先是第一部分是time_embedding:
class TimeEmbedding(nn.Module):
    def __init__(self,T,d_model,dim):
        super().__init__()
        emb = torch.arange(0, d_model, step = 2).float()/d_model * math.log(10000)
        emb = torch.exp(-emb)

        pos = torch.arange(T).float().unsqueeze(1)
        #这个的意思是加维度
        emb = emb.unsqueeze(0)
        emb = pos * emb #为什么要乘起来?
        emb = torch.stack([torch.sin(emb),torch.cos(emb)],dim=-1)
        emb = emb.view(T, d_model)#这向量是怎么个变化?
        self.timeembedding = nn.Sequential(
            nn.Embedding.from_pretrained(emb,freeze=False),#这个的意思是把上面算好的表作为初始权重,freeze=False表示在训练过程中这个权重是可以更新的。
            nn.Linear(d_model,dim),
            nn.SiLU(),
            nn.Linear(dim,dim)
        )
        self.initialize()

    def initialize(self):
            for _ in self.modules():
                if isinstance(_,nn.Linear):
                    init.xavier_uniform_(_.weight)
                    init.zeros_(_.bias)
    def forward(self,t):
        return self.timeembedding(t)
这里顺便定义了激活函数和提取函数:
def extract(v, t, x_shape):
    out = v.gather(dim =0, index=t)
    return out.float().view(t.shape[0],*((1,)*(len(x_shape)-1)))
    #这个return的向量形状不是很清楚,为什么要这么变形?
    #因为这个函数的作用是从长度为 T 的一维系数表 v 中,按 batch 内每张图片的时间步 t 取出对应系数。返回的向量形状是 [B, 1, 1, 1],这样可以和图片张量 [B, C, H, W] 自动广播相乘。

class Swish(nn.Module):
     def forward(self,x):
          return x*torch.sigmoid(x)
2.第二部分是注意力机制,不过用的是卷积版,还有有意思的:
class AttnBlock(nn.Module):
    def __init__(self,in_ch):
        super().__init__()
        self.gropnorm = group_norm(in_ch)

        self.proj_q = nn.Conv2d(in_ch,in_ch,kernel_size=1,stride=1,padding=0)
        self.proj_k = nn.Conv2d(in_ch,in_ch,kernel_size=1,stride=1,padding=0)
        self.proj_v = nn.Conv2d(in_ch,in_ch,kernel_size=1,stride=1,padding=0)
        self.proj = nn.Conv2d(in_ch,in_ch,kernel_size=1,stride=1,padding=0)
        self.initialize()

    def initialize(self):
        for module in [self.proj_q,self.proj_k,self.proj_v,self.proj]:
             init.xavier_normal(module.weight)
             init.zeros_(module.bias)

             init.xavier_normal(self.proj.weight,gain = 1e-5)

    def forward(self,x):
         B,C,H,W = x.shape
         h = self.gropnorm(x)

         q = self.proj_q(h)
         k = self.proj_k(h)
         v = self.proj_v(h)

         q = q.permute(0,2,3,1).view(B,H*W,C)
         k = k.view(B,C,H*W)

         w = torch.matmul(q,k)*(int(C)**-0.5)

         w =  F.softmax(w,dim = -1) #dim=-1的含义?是指在最后一个维度上进行softmax操作,也就是对每个像素位置的注意力权重进行归一化,使得它们的和为1。

         v = v.permute(0,2,3,1).view(B,H*W,C)

         score = torch.matmul(w,v)
         score = score.view(B,H,W,C).permute(0,3,1,2)
         score = self.proj(score)

         return score+x
3.第三部分是框架图里面的Resblock的结构:
主要作用就是把时间步和UNet里面上下采样的结果融合起来:
class Resblock(nn.Module):
    def __init__(self,in_ch,out_ch,tdim,dropout,attn = False):
        super().__init__()

        self.block1 = nn.Sequential(
            group_norm(in_ch),
            Swish(),
            nn.Conv2d(in_ch,out_ch,kernel_size=3,stride=1,padding=1),#为什么要用3*3的卷积核?
        )

        self.tdim_proj = nn.Sequential(
            Swish(),
            nn.Linear(tdim,out_ch),
        )

        self.block2 = nn.Sequential(
            group_norm(out_ch),
            Swish(),
            nn.Dropout(dropout),
            nn.Conv2d(out_ch,out_ch,3,stride=1,padding=1),
        )


        if in_ch != out_ch:
            self.shortcut = nn.Linear(in_ch,out_ch)
        else :
            self.shortcut = nn.Identity()

        self.attn = AttnBlock(out_ch) if attn else nn.Identity()
        self.initialize()

    def initialize(self):
        for _ in self.modules():
            if isinstance(_,(nn.Conv2d,nn.Linear)):
                init.xavier_normal_(_.weight)
                init.zeros_(_.bias)

    def forward(self,x,temb):#为什么这个temb有两维呢?因为这个temb是时间嵌入的结果,通常是一个二维张量,形状为 [B, tdim],其中 B 是批量大小,tdim 是时间嵌入的维度。这个时间嵌入向量会被映射成与图像特征图相同的通道数,并通过广播机制加到特征图上,以便在每个时间步都能提供时间信息。
        h = self.block1(x)
        h = h + self.tdim_proj(temb)[:,:,None,None]
        h = self.block2(h)
        h = h + self.shortcut(h)

        h = self.attn(h)

        return h
4.第四部分就是经典UNet了:
这个之前实现过一次,不多赘述了,敲的过程遇到的问题写在注释里面了:
class DownSample(nn.Module):
    def __init__(self,ch):
        super().__init__()
        self.main = nn.Conv2d(ch,ch,kernel_size= 3 ,stride= 2 ,padding=1)
        init.xavier_normal(self.main.weight)
        init.zeros_(self.main.bias)

    def forward(self,x):
        x = self.main(x)
        return x

class UpSample (nn.Module):
    def __init__(self,ch):
        super().__init__()
        self.main = nn.Conv2d(ch,ch,3,stride=1,padding=1)
        init.xavier_normal(self.main)
        init.zeros_(self.main.bias)

    def forward(self,x):
        x = F.interpolate(x,scale_factor=2,mode='nearest')
        return self.main(x)


#UNet
class UNet(nn.Module):
    def __init__(self,
        T,
        ch = 64,
        ch_mult=(1,2,2),#这是干什么的?这是每个分辨率层级的通道倍率;(1, 2, 2) 表示 64 -> 128 -> 128。
        attn= (1,),#这个是干什么的?为什么加逗号?这是一个元组,表示在哪些层级使用注意力机制;这里默认第 1 层级,也就是 14x14 附近。加逗号是为了让 Python 识别这是一个单元素的元组,而不是一个普通的括号表达式。
        num_res_blocks=2,
        dropout = 0.1,
        in_ch=1,
        out_ch=1,
        ):

        super().__init__()
        self.T = T
        self.ch=ch
        self.tdim=ch*4#为什么*4?这是时间嵌入的维度,通常设置为基础通道数的4倍,以提供足够的表达能力。
        self.num_res_blocks = num_res_blocks

        self.time_embedding=TimeEmbedding(T,ch,self.tdim)
        self.head = nn.Conv2d(in_ch,ch,3,stride=1,padding=1)
#Encoder部分
        self.downblocks = nn.ModuleList()
        chs = [ch]
        now_ch = ch
        for i,mult in enumerate(ch_mult):
            out_channels = ch*mult
            for _ in range(num_res_blocks):
                self.downblocks.append(ResBlock(now_ch,out_channels,self.tdim,dropout,attn=(i in attn)))
                now_ch = out_channels
                chs.append(now_ch)

            if i != len(ch_mult)-1:
                self.downblocks.append(DownSample(now_ch))
                chs.append(now_ch)

#Middle:
        self.middleblocks = nn.Module([
            ResBlock(now_ch,now_ch,self.tdim,dropout,attn=True),
            ResBlock(now_ch,now_ch,self.tdim,dropout,attn=False),
        ])


#Decoder:上采样过程
        self.upblocks = nn.ModuleList()
        for i,mult in reversed(list(enumerate(ch_mult))):
            out_channels=ch*mult
            for _ in range(num_res_blocks+1):
                skip_ch = chs.pop()#这是干什么?chs.pop()是什么用法?这是从列表 chs 中弹出最后一个元素,表示当前层级对应的 skip connection 的通道数。这个通道数会和当前特征图的通道数相加,作为 ResBlock 的输入通道数。
                self.upblocks.append(ResBlock(now_ch+skip_ch,out_channels,self.tdim,dropout,attn=(i in attn)))
                now_ch = out_channels

            if i != 0:
                self.upblocks.append(UpSample(now_ch))

            self.tail = nn.Sequential(
                group_norm(now_ch),
                Swish(),
                nn.Conv2d(now_ch,out_ch,3,stride=1,padding=1),
            )
            self.initialize()

        def initialize(self):
            init.xavier_normal(self.head.weight)
            init.zeros_(self.head.bias)
            init.xavier_normal(self.tail[-1].weight,gain=1e-5)
            init.zeros_(self.tail[-1].bias)

        def forward(self,x,t):
            temb = self.time_embbedding(t)

            h = self.head(x)
            hs = [h]

            for layer in self.downblocks:
                if isinstance (layer,ResBlock):
                    h = layer(h,temb)
                else :
                    h = layer(h)
                hs.append(h)

            for layer in self.middleblocks:
                h = layer(h,temb)#为什么这个layer只要俩个参数?因为 middleblocks 中的 ResBlock 只需要图像特征和时间嵌入作为输入,不涉及下采样或上采样操作,所以不需要额外的参数.
            #为什么可以把h整个传进去?因为 ResBlock 的 forward 方法定义为 def forward(self, x, temb),其中 x 是图像特征,temb 是时间嵌入。无论是在 encoder 还是 middle 部分,输入到 ResBlock 的都是当前的图像特征 h 和时间嵌入 temb,所以直接把 h 传进去就可以了。
            #这个layer是什么东西?其他的layer也是resblock吗?这个layer是 middleblocks 中的 ResBlock 实例,其他的 layer 可能是 downblocks 中的 ResBlock 或 DownSample,upblocks 中的 ResBlock 或 UpSample。根据 isinstance 的判断,代码会自动区分不同类型的 layer,并传入相应的参数。


            #Decoder :
            for layer in self.upblocks:
                if isinstance(layer,ResBlock):
                    skip = hs.pop
                    if h.shape[-2:] != skip.shape[-2:]:#h的形状是什么?skip的形状是什么?h 的形状是当前的图像特征图,通常是 [B, C, H, W];skip 的形状是对应的 skip connection 特征图,通常也是 [B, C_skip, H_skip, W_skip]。如果它们的空间尺寸不一致,就需要通过插值对齐。
                        h = F.interpolate(h,size=skip.shape[-2:],mode='nearest')

                        h = torch.cat([h,skip],dim=1)
                        h = layer(h,temb)
                    else :
                        h = layer(h)

                return self.tail(h)
5.终于到DDPM的环节了,这里先写训练器:
训练器主要是ddpm很像里面的前向的过程,先用前向公式导出x_t,然后让网络预测的噪声接近我们加的噪声:
class GaussianDiffusionTrainer(nn.Module):
    def __init__(self,model,bata_1 = 1e-4,beta_T = 0.02,T=1000):
        super().__init__()
        self.model = model
        self.T = T
        self.register_buffer('betas',torch.linspace(bata_1,beta_T,T).float())#这个的意思是创建一个长度为 T 的一维张量,线性地从 beta_1 增加到 beta_T,并注册为模型的 buffer,这样它就会随着模型一起保存和加载,但不会被优化器更新。
        #为什么beta_T这么小?因为 beta_T 是扩散过程最后一步加入的噪声强度,设置得太大可能会导致生成的图像质量下降;设置得太小可能会导致训练不稳定。通常在 0.01 到 0.02 之间是比较常见的选择。
        alphas = 1.0- self.betas
        alphas_bar = torch.cumprod(alphas,dim=0)#这个函数的作用是计算 alphas 的累积乘积,得到 alpha_bar_t = alpha_1 * alpha_2 * ... * alpha_t,这个值在训练公式中用于计算 x_t 和噪声的权重。
        self.register_buffer('sqrt_alphas_bar',torch.sqrt(alphas_bar))
        self.register_buffer('sqrt_one_minus_alphas_bar',torch.sqrt(1.0-alphas_bar))#这一步是?这是为了在训练公式中直接使用 sqrt(alpha_bar_t) 和 sqrt(1 - alpha_bar_t),避免每次计算时都要进行平方根运算,提高效率。

        def forward(self,x_0):
            B = x_0.shape[0]

            t = torch.randint(self.T,size = (B,),device=x_0.device)#这个函数的写法是这样的吗?每个参数的意义是什么?这是 PyTorch 中的一个函数,用于生成一个形状为 (B,) 的整数张量,元素值在 [0, T) 的范围内,表示每张图片随机抽取的时间步。size 参数指定输出张量的形状,device 参数指定输出张量所在的设备(CPU 或 GPU)。

            noise = torch.randn_like(x_0)
            #这是什么函数?这是 PyTorch 中的一个函数,用于生成与 x_0 形状相同的张量,元素值服从标准正态分布(均值为 0,标准差为 1)。这个噪声张量是用来模拟扩散过程中的随机噪声的。

            x_t = (
                extract(self.sqrt_alphs_bar,t ,x_0.shape)*x_0+
                extract(self.sqrt_one_minus_alphas_bar,t,x_0.shape)*noise
            )

            pred_noise = self.model(x_t,t)
            loss = F.mse_loss(pred_noise,noise,reduction="mean")
            return loss
6.接下来是DDPM的采样器:
这里包含了模型预测噪声,然后实现了数学公式到代码的映射,最后得到我们预测的x_0:
class GaussianDiffusionSampler(nn.Module):
    def __init__(self, model, beta_1=1e-4, beta_T=0.02, T=1000):
        super().__init__()
        self.model = model
        self.T = T

        self.register_buffer('betas', torch.linspace(beta_1, beta_T, T).float())
        alphas = 1.0 - self.betas
        alphas_bar = torch.cumprod(alphas, dim=0)
        alphas_bar_prev = F.pad(alphas_bar,[1,0],value=1.0)[:T]
        #这里面每个参数是什么意思?这是为了计算反向分布的方差时需要用到的 alpha_bar_{t-1},由于 alpha_bar 的第 0 项对应 t=0 时的值为 1,所以通过在前面填充一个 1.0 来实现对齐。pad 参数 [1, 0] 表示在第一个维度前面填充 1 个元素,后面不填充;value=1.0 表示填充的值为 1.0;[:T] 是为了去掉多余的最后一项,使得 alphas_bar_prev 的长度与 T 一致。


        self.register_buffer('coeff1',torch.sqrt(1.0/alphas))
        self.register_buffer('coeff2',self.coeff1*(1.0 - alphas)/torch.sqrt(1.0-alphas_bar))
        self.register_buffer('posterior_var', self.betas * (1.0 - alphas_bar_prev) / (1.0 - alphas_bar))

    def predict_xt_prev_mean_from_eps(self,x_t,t,eps):
        return (
            extract(self.coeff1,t,x_t.shape)*x_t-
            extract(self.corff2,t,x_t.shape)*eps
        )

    def p_mean_varince(self,x_t,t):
        var = torch.cat([self.posteriior_var[1:2],self.betas[1:]])#这一行什么意思?这是为了处理 t=0 时 posterior_var 为 0 的情况,避免数值不稳定。通过将 posterior_var 的第 1 项(对应 t=1 的值)替代第 0 项,使得在 t=0 时也有一个合理的方差值,从而保证采样过程的稳定性。
        var = extract(var,t,x_t.shape)

        eps = self.model(x_t,t)
        xt_prev_mean = self.predict_xt_prev_mean_from_eps(x_t,t,eps=eps)
        return xt_prev_mean,var

    @torch.no_grad()
    def forward(self,x_T):
        x_t = x_T
        for time_step in reversed(range(self.T)):
            t = x_t.new_full((x_t.shape[0],),time_step,dtype = torch.long)
            mean,var = self.p_mean_varince(x_t=x_t,t=t)

            if time_step > 0:
                noise = torch.randn_like(x_t)

            else :
                noise = 0

            x_t = mean + torch.sqrt(var)*noise

        x_0 = x_t
        return torch.clip(x_0,-1.0,1.0)#clip在干什么?这是为了确保生成的图像像素值在 [-1, 1] 的范围内,因为在训练阶段我们将输入图像归一化到了这个范围。clip 函数会将 x_0 中的值限制在指定的范围内,超过 -1.0 的部分会被设置为 -1.0,超过 1.0 的部分会被设置为 1.0,从而保证输出的图像数据合法.
小结:
这次train和inference的过程依旧没写hh(),最近期末周+一堆ddl时间有点紧张,周末学完ddpm之后这周几乎没什么实质性推进,后面还是要合理规划一下时间。
从ddpm的架构来看,感觉挺老的,毕竟用的还是CNN+UNet哈哈,而且这种一步一步还原噪声的过程本身感觉就是一种比较低效的东西,虽然有batch,但是感觉天然不如transformer的训练和推理来的高效。