深度强化学习中的时序信用分配:问题定义与典型方法
Haoran Qian · 收录于
概述
这篇综述讨论的核心问题是:智能体得到一个结果后,怎样判断过去哪些动作真正促成了这个结果。论文没有提出一种新的信用分配算法,而是统一定义了信用分配问题,并从 MDP 的深度、密度和广度三个维度解释现有方法为什么会失败,随后梳理了基于时间邻近性和回报分解的两类代表性方法。
论文链接:A Survey of Temporal Credit Assignment in Deep Reinforcement Learning
1. 信用分配问题是什么
强化学习通常只告诉智能体最终获得了多少奖励,却不会直接说明奖励应该归因于哪个动作。
例如,在“拿钥匙—开门—到达终点”的任务中,智能体可能先拿到钥匙,随后执行很多无关动作,最后打开门并得到奖励。真正关键的是很早之前“拿钥匙”的动作,但它和奖励之间隔了很长时间。如果算法只是强化奖励出现前的几个动作,就可能把信用错误地分给那些无关动作。
这就是时序信用分配问题:学习过去动作和未来结果之间的联系。
论文进一步指出,信用分配不能简单理解成“把奖励平均分给过去的动作”。更准确地说,它是在学习一个动作影响函数:
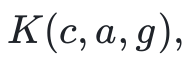
其中 cc 表示动作发生时的上下文,aa 是动作,gg 是需要评价的目标。K(c,a,g) 表示动作 a 在上下文 c 中对目标 g 有多大影响。
实际算法无法直接获得真实的K,只能利用有限经验D,训练一个参数化函数:
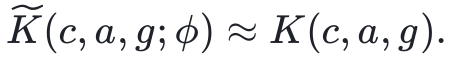
因此,论文将信用分配问题形式化为:
如何利用有限经验,学习一个能够准确估计动作影响力的函数。
这里存在一个基本矛盾:越接近真实因果关系的影响力度量,通常越难从有限经验中学习;Q 值等统计量比较容易学习,但它们反映的主要是相关性,不一定是真正的因果贡献。
2. 价值学习为什么与信用分配有关
在MDP中,从时刻t开始的回报为:
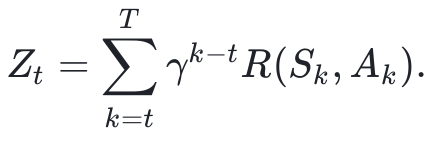
状态价值函数和动作价值函数分别为:
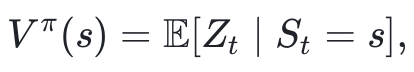
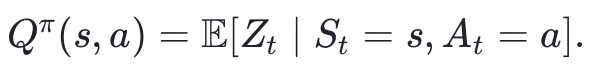
Q 值把未来可能获得的回报压缩成当前动作的一个数值,因此经常被当作动作影响力的代理。广义策略迭代会交替进行:
1. 策略评估:估计当前策略的 V 或 Q;
2. 策略改进:选择价值更高的动作。
因此,如果价值函数错误地把高价值赋给了无关动作,策略也会沿着错误方向更新。信用分配的质量最终会影响训练速度、样本效率和策略质量。
不过,Q 值并不等于严格意义上的信用。它回答的是“采取这个动作后预计能获得多少回报”,而不是“这个动作究竟在多大程度上导致了该结果”。
3. 信用分配的三类困难
论文用 MDP的深度、密度和广度整理了信用分配中的主要困难。
3.1 MDP 深度:动作与结果相隔太远
MDP深度表示重要动作与结果之间隔了多少个时间步。深度越大,信用就需要沿着更长的时间链向前传播。
中间还可能夹杂大量无关动作,使算法容易把信用分给时间上接近奖励、但并没有真正促成奖励的动作。这对应延迟奖励和长期信用分配问题。
3.2 MDP 密度:真正有影响的动作太少
MDP 密度反映动作与目标之间有效关联的丰富程度。
当环境随机性很强,或者只有极少数状态和动作序列能够产生奖励时,大多数动作几乎不改变结果。智能体很少得到有信息量的学习信号,也就没有足够的信用可以向前传播。
这通常表现为稀疏奖励问题。
3.3 MDP 广度:到达同一结果的路径太多
MDP 广度表示有多少条不同路径可以产生相同结果。
如果很多动作序列都能到达目标,就不存在唯一的关键路径,信用会被分散到大量可能路径中。智能体只找到一条成功轨迹时,可能错误地认为这条轨迹中的动作都非常重要,却不知道其他动作组合也能获得相同结果。
论文将这种现象称为信用稀释。
3.4 信用分配与探索的区别
探索负责发现成功轨迹,信用分配负责理解成功轨迹。
在钥匙—门任务中,探索让智能体偶然发现“拿钥匙—开门—到达终点”的序列;信用分配则负责学到“拿钥匙是后来开门的必要条件”,从而在以后主动重复这一行为。
如果智能体从未发现奖励,主要问题可能是探索;如果已经见过成功轨迹,却仍然学不会重复关键动作,问题更可能出在信用分配上。实际训练中两者经常互相影响,因此很难完全分开。
4. 基于时间邻近性的信用分配
第 6.1 节介绍的方法共享一个基本假设:
动作在时间上离结果越近,对结果的影响就越大。
这是一种简单而有效的启发式规则,但时间先后和真正的因果关系并不是一回事。
4.1 TD 学习
TD 学习使用下面的 TD 误差更新价值函数:
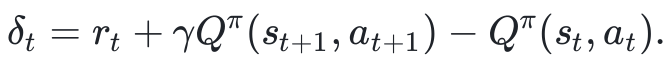
如果实际观察到的“即时奖励加下一状态价值”高于当前估计,说明当前状态—动作对被低估;反之则说明它被高估。
TD 并不是把最终奖励显式拆成若干份,而是利用 TD 误差不断调整状态—动作对的价值。通过反复自举,奖励信息可以从后面的状态逐步传播到前面的状态。
它的问题也很直接:奖励信息通常只能逐步向前传递。任务很长时,早期关键动作需要经过很多轮更新才能得到正确价值,而且中间动作也可能因为靠近奖励而被错误强化。
4.2 基于优势函数的方法
优势函数定义为:
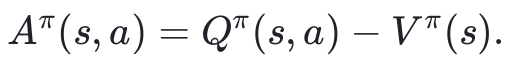
它衡量的不是动作能够获得多少绝对回报,而是:
在当前状态下,动作 aa 比策略平均会采取的动作好多少。
Actor–Critic 使用 Vπ(s) 作为基线,可以在不改变策略梯度期望的情况下减小方差。优势函数也更适合比较同一状态下的不同动作。
Dueling DQN 把 Q 值分解为状态价值和动作优势:
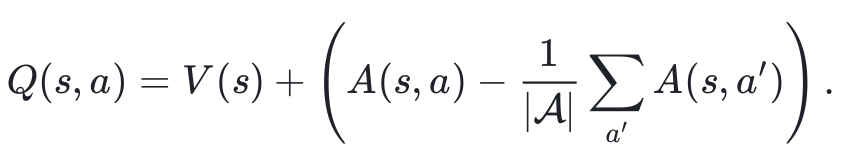
这样可以分别学习“这个状态总体上好不好”和“某个动作相对其他动作好不好”。
在完全可观测 MDP 中,优势还可以近似写成动作的因果效应:
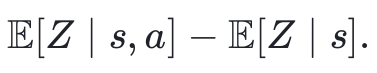
但这仍不是真正完整的因果估计,因为 Q 值和 V 值都受到后续策略、环境随机性等因素影响。
4.3 资格迹
资格迹为过去访问过的状态—动作对维护一个随时间衰减的权重:
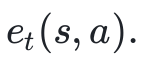
当状态—动作对被访问时,它的资格迹上升;之后随时间逐渐衰减。当前产生 TD 误差时,不只更新当前动作,还按照资格迹更新过去的动作:
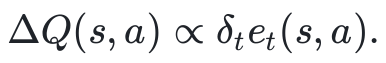
因此,资格迹实际分配的是:
当前 TD 误差应当以多大权重更新过去的状态—动作对。
距离当前时间越近的动作通常具有越大的迹,因此获得更强的更新。经典 TD 就使用资格迹实现多步信用传播,它位于单步 TD 和蒙特卡洛回报之间。
资格迹能够比单步 TD 更快地向过去传播信息,但它仍然依赖时间邻近性。一个动作即使没有真正影响结果,只要它最近被访问过,也可能获得较高权重。
ETD 在此基础上引入强调迹和兴趣函数,重新调整不同状态更新的重要程度,主要用于缓解离策略学习与函数逼近结合时的不稳定问题。
4.4 Options 与 Option-Critic
另一种思路是把多个原子动作组合成一个时间上延展的宏动作,即 option 或 skill。
例如,可以把“移动到钥匙旁并捡起钥匙”看成一个 option,而不是分别评价其中每一步移动。这样,一条数百步的动作序列可能被压缩成:
拿钥匙→开门→到达终点.拿钥匙→开门→到达终点.
信用传播的有效时间跨度因此变短。
Option-Critic 同时学习:
•
option 内部应该执行哪些原子动作;
•
什么时候终止当前 option;
•
当前状态应该选择哪个 option。
所以它包含两层信用分配:
1. 将子目标的信用分配给 option 内部动作;
2. 将最终任务的信用分配给不同 options。
这种方法适合具有明显层次结构的长任务,但如果子目标或 option 划分不合理,问题本身并不会自动消失。
5. 回报分解方法
第 6.2 节尝试回答一个更直接的问题:
最终回报中的多少部分应该归因于每个时间步?
这类方法把终止时得到的回报重新分配到轨迹中的关键位置,构造更清晰、更及时的学习信号。
5.1 TVT:通过记忆传输价值
Temporal Value Transport 使用外部长时记忆保存过去的重要事件。
当智能体在当前时刻获得重要结果时,模型会从记忆中读取与当前结果相关的过去状态—动作对,并把当前价值直接传输回这些遥远事件。
因此,TVT 中的信用主要由记忆检索关系决定:
•
某个过去事件越容易在预测当前结果时被检索出来;
•
就认为它对当前结果越重要。
这种方法可以绕过很长的时间距离,但记忆检索到的是相关性,不一定是严格因果关系。
5.2 RUDDER:用回报预测差分重新分配奖励
RUDDER 先使用 LSTM 根据整条状态—动作序列预测最终回报。假设模型在看到某个关键动作后,对最终回报的预测突然上升,那么这次预测变化就说明该动作提供了重要信息。
它把相邻时间步的回报预测差定义为重新分配后的奖励:
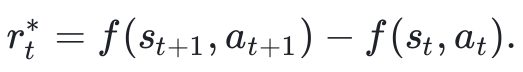
相比普通 TD,这种方法能够更直接地处理长时间延迟。但它依赖回报预测模型是否准确,而且目前缺少一般性的理论保证,不能证明重新分配一定比 TD 更正确。
5.3 SECRET:把注意力权重作为信用
SECRET 使用因果 Transformer,根据观察和动作序列预测奖励序列。
模型预测某个奖励时,会对过去不同状态—动作对分配注意力权重。SECRET 将这些注意力权重解释为过去动作对奖励的贡献:
•
注意力越高,分配的信用越多;
•
注意力越低,分配的信用越少。
它的优点是能够直接建立长距离关联,而且在任务分布上训练后可以迁移到新任务。
但需要注意,注意力权重只能说明模型在预测时使用了哪些信息,不能自动证明这些信息在因果上造成了奖励。因此,“attention is credit”更像一种有效启发式,而不是严格结论。
5.4 SR:学习合成奖励
Synthetic Returns 假设终止奖励主要由一个早期关键事件造成。它把较早出现、能够预示后续奖励的状态称为 operant,把后来真正产生奖励的状态称为 reinforcer。模型通过情景记忆学习两者之间的关联,然后在再次观察到 operant 时直接产生合成奖励。
例如,模型学会“拿到钥匙通常预示之后能够得到终点奖励”,那么以后拿到钥匙时就立即产生一个合成奖励,而不必等待最终奖励逐步传播回来。
该方法能够绕过局部 TD 更新,但限制比较明显:
•
假设主要只有一个动作应当获得信用;
•
对超参数较敏感;
•
面对多个动作共同促成结果的任务时不够自然。
6. 这些方法汇总
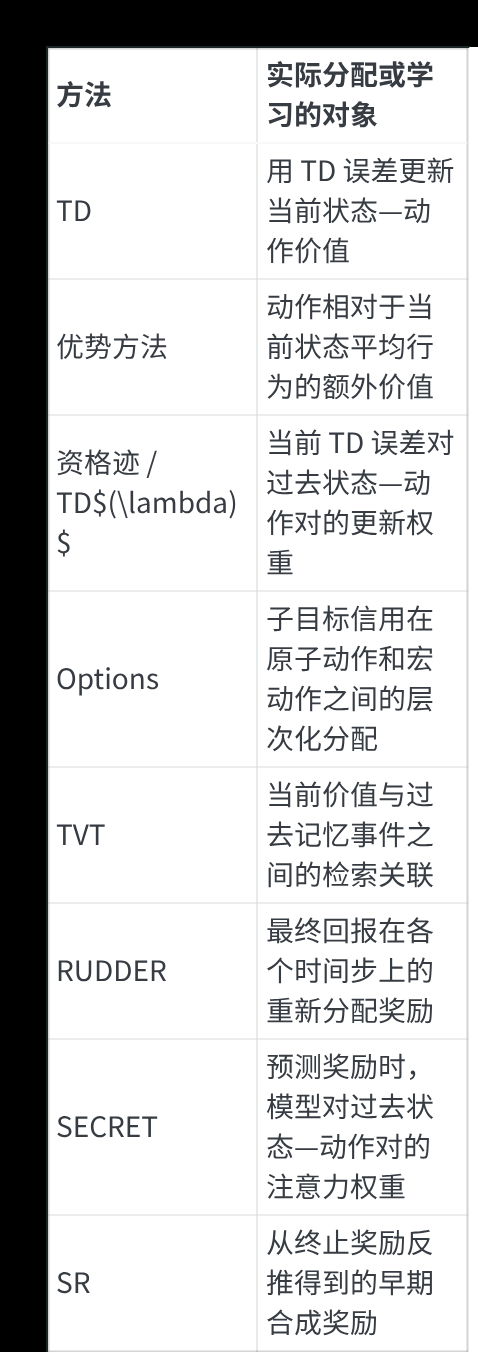
其中,只有 RUDDER、SECRET、SR 等方法比较接近“把一个最终回报拆成每一步的贡献”。TD 和资格迹做的主要是价值更新与误差传播,并没有显式回答“最终奖励中有多少属于这个动作”。
7. 总结与理解
这篇综述最有价值的地方,是把一个比较模糊的问题转换成了统一的函数学习问题:从有限经验中估计动作对结果的影响。
第 6.1 节的方法主要依赖时间结构。TD 使用自举逐步传播奖励,资格迹一次更新多个过去动作,优势函数评价动作相对于平均行为的额外价值,options 则通过时间抽象缩短信用传播距离。这些方法容易与现有 RL 算法结合,但共同的问题是容易把时间邻近性误认为因果关系。
第 6.2 节的方法更主动地寻找长距离关联。TVT 使用记忆检索,RUDDER 根据回报预测变化重新分配奖励,SECRET 使用注意力权重,SR 学习合成奖励。它们在延迟奖励任务上通常比普通 TD 更有效,但检索分数、预测差分和注意力权重仍然只是动作影响力的近似,并不等于严格的因果信用。
因此,信用分配并不存在一种对所有任务都最合适的方法。延迟不严重时,TD 和 TD 已经足够有效;任务具有明显层次结构时,可以使用 options;最终奖励延迟很长时,回报分解和记忆方法更有优势。而对于奖励极度稀疏或存在大量替代路径的任务,仅靠这些方法仍然不够,还需要目标条件化、事后重标记、反事实推理或反向规划等方法。