从零开始实现Transformer ViT UNet
Haoran Qian · 收录于
写在开头: 本文主要记录了皓冉在搓代码的时候的一些理解和心得,包含但不限于皓冉寒假初学的时候的一些笔记。具体的代码已经上传GitHub,https://github.com/Arison591/Coding-from-Zero-Series,实现的主要是一些核心算法,没有包含数据处理和训练的过程。(叠甲hh)
Transformer
先来看基础的transformer。这里先是自己手搓了一版,后面ai矫正了,前后对比图:
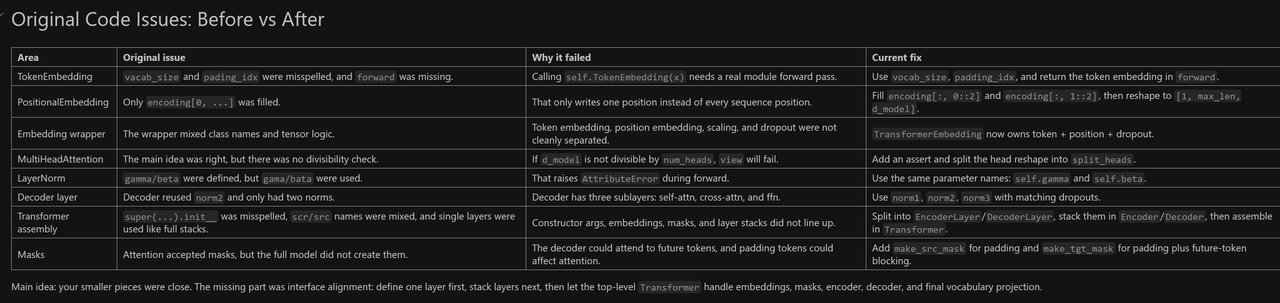
那一个模块一个模块的看:
TokenEmbedding&PositionalEmbedding
class TokenEmbedding(nn.Module):
    def __init__(self, vocab_size, d_model, padding_idx=1):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, d_model, padding_idx=padding_idx)
        self.d_model = d_model

    def forward(self, x):
        return self.embedding(x) * math.sqrt(self.d_model)

 class PositionalEmbedding(nn.Module):
    def __init__(self, d_model, max_len, device):
        super().__init__()

        # shape: [1, max_len, d_model],前面的 1 用来和 batch 维度广播相加
        encoding = torch.zeros(max_len, d_model, device=device)
        position = torch.arange(0, max_len, device=device).unsqueeze(1)
        div_term = torch.exp(torch.arange(0, d_model, 2, device=device) * (-math.log(10000.0) / d_model))

        encoding[:, 0::2] = torch.sin(position * div_term)
        encoding[:, 1::2] = torch.cos(position * div_term)
        self.register_buffer("encoding", encoding.unsqueeze(0))#这是在模型中注册一个持久缓冲区,表示这个变量不需要梯度更新,但会随着模型一起保存和加载

    def forward(self, x):
        # x: [batch_size, seq_len]
        seq_len = x.size(1)
        return self.encoding[:, :seq_len, :]


# This wrapper is the clean place to combine token embedding, position embedding, scaling, and dropout.
class TransformerEmbedding(nn.Module):
    def __init__(self, vocab_size, d_model, max_len, dropout, device, padding_idx=1):
        super().__init__()
        self.token_embedding = TokenEmbedding(vocab_size, d_model, padding_idx)
        self.positional_embedding = PositionalEmbedding(d_model, max_len, device)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        token_emb = self.token_embedding(x)
        pos_emb = self.positional_embedding(x)
        return self.dropout(token_emb + pos_emb)


# 保留你原来的类名习惯,后面如果已经写了 Embedding(...) 也还能用
Embedding = TransformerEmbedding
第一个embedding主要用的就是nn.Embedding(),这里还专门除以根号下d_model,token embedding被scaled以保持数值稳定性。
后面的positionalEmbedding就比较复杂了,这里主要是那个旋转编码的公式的实现,即这个公式:
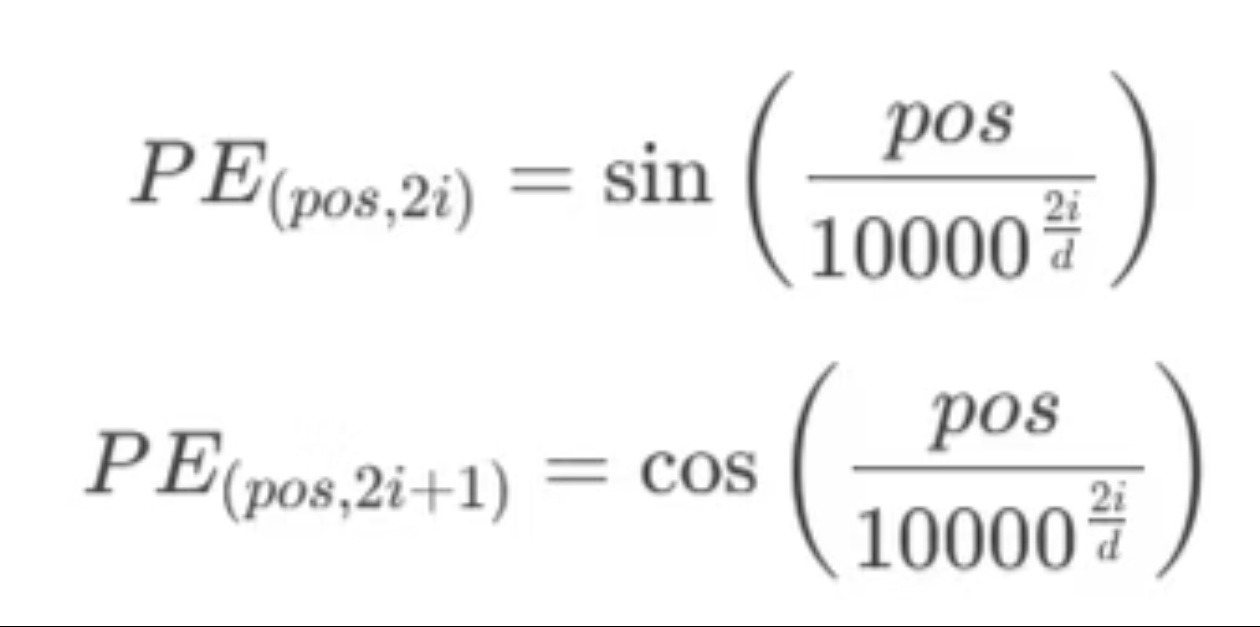
然后就是把两个嵌入相加再来个dropout。
MultiHeadAttention:
class MultiHeadAttention(nn.Module):
    def __init__(self, d_model, num_heads):
        super().__init__()
        assert d_model % num_heads == 0, "d_model 必须能被 num_heads 整除"

        self.d_model = d_model
        self.num_heads = num_heads
        self.d_k = d_model // num_heads

        self.W_q = nn.Linear(d_model, d_model)
        self.W_k = nn.Linear(d_model, d_model)
        self.W_v = nn.Linear(d_model, d_model)
        self.W_combine = nn.Linear(d_model, d_model)
        self.dropout = nn.Dropout(0.1)

    def split_heads(self, x):
        batch_size, seq_len, _ = x.size()
        # [batch, seq_len, d_model] -> [batch, num_heads, seq_len, d_k]
        return x.view(batch_size, seq_len, self.num_heads, self.d_k).transpose(1, 2)

    def forward(self, q, k, v, mask=None):
        batch_size = q.size(0)

        q = self.split_heads(self.W_q(q))
        k = self.split_heads(self.W_k(k))
        v = self.split_heads(self.W_v(v))

        scores = torch.matmul(q, k.transpose(-2, -1)) / math.sqrt(self.d_k)
        if mask is not None:
            # mask 会广播到 [batch, num_heads, query_len, key_len]
            scores = scores.masked_fill(mask == 0, -1e9)

        attn = torch.softmax(scores, dim=-1)
        context = torch.matmul(self.dropout(attn), v)
        context = context.transpose(1, 2).contiguous().view(batch_size, -1, self.d_model)
        return self.W_combine(context)
这个感觉没什么好说的,都已经搓烂了hh,可能需要注意的是它的一个向量的形状,会有一个transpose(1, 2)把seq_len,num_heads做一个转置,后面换回来。
LayerNorm:
直接放代码块:
class LayerNorm(nn.Module):
    def __init__(self, d_model, eps=1e-6):
        super().__init__()
        self.eps = eps
        self.gamma = nn.Parameter(torch.ones(d_model))
        self.beta = nn.Parameter(torch.zeros(d_model))

    def forward(self, x):
        mean = x.mean(dim=-1, keepdim=True)
        var = x.var(dim=-1, keepdim=True, unbiased=False)
        x = (x - mean) / torch.sqrt(var + self.eps)
        return self.gamma * x + self.beta
#gamma和beta是干什么的?这是Layer Normalization中的可学习参数。gamma(缩放参数)用于调整归一化后的输出的尺度,而beta(偏移参数)用于调整归一化后的输出的偏移。这两个参数允许模型在进行归一化后重新调整数据的分布,从而提高模型的表达能力和性能。
Encoder&Decoder:
直接上代码:
# One EncoderLayer is only one block; the full Encoder below stacks several of these blocks.
class EncoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ffn, dropout):
        super().__init__()
        self.self_attn = MultiHeadAttention(d_model, num_heads)
        self.ffn = nn.Sequential(
            nn.Linear(d_model, d_ffn),
            nn.ReLU(),
            nn.Dropout(dropout),
            nn.Linear(d_ffn, d_model),
        )
        self.norm1 = LayerNorm(d_model)
        self.norm2 = LayerNorm(d_model)
        self.dropout1 = nn.Dropout(dropout)
        self.dropout2 = nn.Dropout(dropout)

    def forward(self, x, src_mask=None):
        attn_output = self.self_attn(x, x, x, src_mask)
        x = self.norm1(x + self.dropout1(attn_output))
        ffn_output = self.ffn(x)
        x = self.norm2(x + self.dropout2(ffn_output))
        return x

# DecoderLayer has three sublayers: masked self-attn, cross-attn, then feed-forward.
class DecoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ffn, dropout):
        super().__init__()
        self.self_attn = MultiHeadAttention(d_model, num_heads)
        self.cross_attn = MultiHeadAttention(d_model, num_heads)
        self.ffn = nn.Sequential(
            nn.Linear(d_model, d_ffn),
            nn.ReLU(),
            nn.Dropout(dropout),
            nn.Linear(d_ffn, d_model),
        )
        self.norm1 = LayerNorm(d_model)
        self.norm2 = LayerNorm(d_model)
        self.norm3 = LayerNorm(d_model)
        self.dropout1 = nn.Dropout(dropout)
        self.dropout2 = nn.Dropout(dropout)
        self.dropout3 = nn.Dropout(dropout)

    def forward(self, x, enc_output, src_mask=None, tgt_mask=None):
        self_attn_output = self.self_attn(x, x, x, tgt_mask)
        x = self.norm1(x + self.dropout1(self_attn_output))

        cross_attn_output = self.cross_attn(x, enc_output, enc_output, src_mask)
    # #为什么会有两个enc_output呢?这是因为在DecoderLayer中,cross-attention机制需要同时使用编码器的输出(enc_output)作为键(key)和值(value),而解码器当前的输入(x)作为查询(query)。因此,cross_attn函数的参数中会有两个enc_output,一个用于生成键,另一个用于生成值。这种设计允许解码器在生成每个输出时都能参考编码器的全部信息,从而更好地捕捉输入序列的上下文关系。
        x = self.norm2(x + self.dropout2(cross_attn_output))
        x = self.norm2(x + self.dropout2(cross_attn_output))

        ffn_output = self.ffn(x)
        x = self.norm3(x + self.dropout3(ffn_output))
        return x

class Encoder(nn.Module):
    def __init__(self, vocab_size, d_model, num_heads, d_ffn, n_layers, dropout, max_len, device, padding_idx=1):
        super().__init__()
        self.embedding = TransformerEmbedding(vocab_size, d_model, max_len, dropout, device, padding_idx)
        self.layers = nn.ModuleList([
            EncoderLayer(d_model, num_heads, d_ffn, dropout)
            for _ in range(n_layers)
        ])

    def forward(self, src, src_mask=None):
        x = self.embedding(src)
        for layer in self.layers:
            x = layer(x, src_mask)
        return x

class Decoder(nn.Module):
    def __init__(self, vocab_size, d_model, num_heads, d_ffn, n_layers, dropout, max_len, device, padding_idx=1):
        super().__init__()
        self.embedding = TransformerEmbedding(vocab_size, d_model, max_len, dropout, device, padding_idx)
        self.layers = nn.ModuleList([
            DecoderLayer(d_model, num_heads, d_ffn, dropout)
            for _ in range(n_layers)
        ])

    def forward(self, tgt, enc_output, src_mask=None, tgt_mask=None):
        x = self.embedding(tgt)
        for layer in self.layers:
            x = layer(x, enc_output, src_mask, tgt_mask)
        return x
Transformer的组合模块:
# The top-level Transformer only assembles parts: masks, encoder, decoder, and output projection.
class Transformer(nn.Module):
    def __init__(
        self,
        src_pad_idx,
        trg_pad_idx,
        enc_voc_size,
        dec_voc_size,
        d_model=512,
        nhead=8,
        ffn_hidden=2048,
        n_layers=6,
        drop_prob=0.1,
        max_len=5000,
        device="cpu",
    ):
        super().__init__()
        self.device = torch.device(device)
        self.src_pad_idx = src_pad_idx
        self.trg_pad_idx = trg_pad_idx

        self.encoder = Encoder(
            enc_voc_size, d_model, nhead, ffn_hidden, n_layers, drop_prob, max_len, self.device, src_pad_idx
        )
        self.decoder = Decoder(
            dec_voc_size, d_model, nhead, ffn_hidden, n_layers, drop_prob, max_len, self.device, trg_pad_idx
        )
        self.fc_out = nn.Linear(d_model, dec_voc_size)
    '''这些mask的作用和具体内容长什么样子?
    src_mask 用于 encoder 的自注意力,遮住输入序列中的填充符位置;tgt_mask 用于 decoder 的自注意力,既遮住目标序列中的填充符位置,也遮住未来位置(即右侧位置)。
    '''
    def make_src_mask(self, src):
        # src: [batch, src_len] -> [batch, 1, 1, src_len]
        return (src != self.src_pad_idx).unsqueeze(1).unsqueeze(2)#src != self.src_pad_idx 是一个布尔张量,表示哪些位置不是填充符;unsqueeze 用来增加维度以适应后续计算。

    def make_tgt_mask(self, tgt):
        # padding mask: [batch, 1, 1, tgt_len]
        tgt_pad_mask = (tgt != self.trg_pad_idx).unsqueeze(1).unsqueeze(2)

        # subsequent mask: [1, 1, tgt_len, tgt_len],遮住未来位置
        tgt_len = tgt.size(1)
        subsequent_mask = torch.tril(torch.ones((tgt_len, tgt_len), device=tgt.device)).bool()
        subsequent_mask = subsequent_mask.unsqueeze(0).unsqueeze(1)

        return tgt_pad_mask & subsequent_mask

    def forward(self, src_input, trg_input):
        # src_input: [batch, src_len]
        # trg_input: [batch, trg_len],训练时通常传入右移后的目标序列
        src_mask = self.make_src_mask(src_input)
        tgt_mask = self.make_tgt_mask(trg_input)

        enc_output = self.encoder(src_input, src_mask)
        dec_output = self.decoder(trg_input, enc_output, src_mask, tgt_mask)
        return self.fc_out(dec_output)
这里有一点很值得注意到是def make_src_mask这个函数,这个是为了让模型不看padding的,有意思在于这个padding的出现是因为一个batch里面的序列长度可能不一样,所以要用0补齐
同理下面这个函数也有这个功能,同时还多了一个防止偷看未来的功能
src_mask = 不看源句子的 pad tgt_mask = 不看目标句子的 pad + 不偷看未来
ViT
由于ViT和transformer有很多相同的地方,所以这里只挑不一样的地方去说明一下。
ViT说白了就是把一张图片切成很多小块,把每个小块当成“词”,再像 Transformer 读句子一样去理解整张图。
PatchEmbedding:
先看代码:
class PatchEmbedding(nn.Module):
    # Patch Embedding: 把整张图切成 patch,并投影到统一的 embedding 维度。
    def __init__(self, img_size=224, patch_size=16, in_chans=3, embed_dim=768):
        super().__init__()
        if img_size % patch_size != 0:
            raise ValueError('img_size must be divisible by patch_size')

        self.img_size = img_size
        self.patch_size = patch_size
        # patch 总数 N = (H / P) * (W / P)
        self.num_patches = (img_size // patch_size) ** 2
        # 卷积层一步同时完成“切块 + 线性投影”,其中 kernel_size = stride = patch_size
        self.proj = nn.Conv2d(
            in_channels=in_chans,
            out_channels=embed_dim,
            kernel_size=patch_size,
            stride=patch_size,
        )

    def forward(self, x):
        # 输入形状: [B, C, H, W]
        x = self.proj(x)              # [B, E, H/P, W/P]
        x = x.flatten(2)             # [B, E, N]
        x = x.transpose(1, 2)        # [B, N, E]
        return x
这里最关键的就是用一步卷积去完成切块 + 线性投影,因为kernel_size = stride = patch_size ,所以每个窗口刚好对应一个 patch,而且 patch 之间不重叠。
EncoderBlock:
这里是把embedding和attention和mlp做一个整合:
class EncoderBlock(nn.Module):
    # 一个完整的 ViT Encoder Block: LN -> MSA -> Residual -> LN -> MLP -> Residual
    def __init__(self, dim, num_heads, mlp_ratio=4.0, drop=0.0):
        super().__init__()
        self.norm1 = nn.LayerNorm(dim)
        self.attn = MultiHeadAttention(dim, num_heads=num_heads, proj_drop=drop)
        self.norm2 = nn.LayerNorm(dim)
        self.mlp = MLP(dim, mlp_ratio=mlp_ratio, drop=drop)

    def forward(self, x):
        # 第一条残差支路: 全局 token 之间通过 self-attention 交互。
        x = x + self.attn(self.norm1(x))
        # 第二条残差支路: 每个 token 各自经过 MLP 做非线性变换。
        x = x + self.mlp(self.norm2(x))
        return x
VisionTransformer:
具体的想法都在代码的注释里面了:
class VisionTransformer(nn.Module):
    def __init__(
        self,
        img_size=224,
        patch_size=16,
        in_chans=3,
        num_classes=1000,
        embed_dim=768,
        depth=4,
        num_heads=8,
        mlp_ratio=4.0,
        drop=0.0,
    ):
        super().__init__()
        # 第一步: 把图像变成 patch token 序列。
        self.patch_embed = PatchEmbedding(
            img_size=img_size,
            patch_size=patch_size,
            in_chans=in_chans,
            embed_dim=embed_dim,
        )
        num_patches = self.patch_embed.num_patches

        # cls_token 用来汇聚整张图像的信息,最终拿它做分类。
        self.cls_token = nn.Parameter(torch.zeros(1, 1, embed_dim))#这个torch函数为什么用zeros?是因为在训练过程中,cls_token 会被优化器更新,所以初始值可以是零。虽然也可以用其他初始化方法,但零初始化是常见且简单的选择。
        # 位置编码长度是 num_patches + 1,因为还包含一个 cls_token。
        self.pos_embed = nn.Parameter(torch.zeros(1, num_patches + 1, embed_dim))
        self.pos_drop = nn.Dropout(drop)

        # 堆叠多个 Transformer encoder block。
        self.blocks = nn.Sequential(
            *[
                EncoderBlock(
                    dim=embed_dim,
                    num_heads=num_heads,
                    mlp_ratio=mlp_ratio,
                    drop=drop,
                )
                for _ in range(depth)
            ]
        )
        self.norm = nn.LayerNorm(embed_dim)
        self.head = nn.Linear(embed_dim, num_classes)

        nn.init.trunc_normal_(self.cls_token, std=0.02)
        nn.init.trunc_normal_(self.pos_embed, std=0.02)

    def forward(self, x):
        x = self.patch_embed(x)
        # 为 batch 中的每张图复制一个 cls_token。
        cls_token = self.cls_token.expand(x.shape[0], -1, -1)
        x = torch.cat((cls_token, x), dim=1)
        # 加上位置编码,否则模型无法区分 patch 的空间顺序。
        x = x + self.pos_embed
        x = self.pos_drop(x)
        x = self.blocks(x)
        x = self.norm(x)
        # 取第 0 个 token,也就是 cls_token,接分类头得到 logits。
        logits = self.head(x[:, 0])
        return logits
UNet
DoubleCov:
class DoubleCov(nn.Module):
    def __init__(self, in_channels, out_channels,mid_channels = None):
        super().__init__()
        if not mid_channels:
            mid_channels = out_channels
        self.double_conv = nn.Sequential(
            # padding=1 可以保持特征图宽高不变;原来的 padding=-1 在 PyTorch 中是非法参数。
            nn.Conv2d(in_channels,mid_channels,kernel_size=3,padding=1,bias=False),
            nn.BatchNorm2d(mid_channels),
            nn.ReLU(inplace=True),
            nn.Conv2d(mid_channels,out_channels,kernel_size=3,padding=1,bias=False),
            # 第二个 BatchNorm 的通道数要和上一层卷积输出 out_channels 对齐。
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True)
        )

    def forward(self,x):
        return self.double_conv(x)
这一个模块是一个双层卷积,第一个部分是增加通道数,同时缩小图片尺寸(后面用padding补回来了),再进行归一化处理。第二层是为了提取更细节的特征,不在通道数上面做改变。
Down:
class Down(nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()
        self.max_pool_convd = nn.Sequential(
            nn.MaxPool2d(2),
            DoubleCov(in_channels,out_channels)
        )

    def forward(self,x):
        return self.max_pool_convd(x)
这是下采样的过程,主要是最大池化和二层卷积。
Up:
class Up(nn.Module):
    def __init__(self, in_channels, out_channels,bilinear = True):
        super().__init__()
        if bilinear:
            self.up = nn.Upsample(scale_factor=2 , mode='bilinear',align_corners= True)
            self.conv = DoubleCov(in_channels,out_channels,in_channels//2)

        else:
            # 这里不能加逗号,否则 self.up 会变成 tuple,forward 时不能像模块一样调用。
            self.up = nn.ConvTranspose2d(in_channels,in_channels//2,kernel_size = 2,stride= 2)
            self.conv = DoubleCov(in_channels,out_channels)


    def forward(self,x1,x2):
            x1 = self.up(x1)

            diffY = x2.size()[2]-x1.size()[2]
            diffX = x2.size()[3]-x1.size()[3]

            x1 = F.pad(x1,[diffX// 2 , diffX - diffX//2,
                           diffY//2 , diffY - diffY//2])

            x = torch.cat([x2,x1],dim = 1)

            return self.conv(x)
上采样的时候和下采样差的不多,值得注意的是,这个bilinear的部分,使用双插值的时候,直接进行Upsample,所以这里向量的形状有点绕。
同时有一个concat的操作, 把encoder 的细节特征和 decoder 的语义特征合在一起。
UNet的拼装:
class UNet(nn.Module):
     def __init__(self, n_channels, n_classes,bilinear = False):
        super().__init__()
        self.n_channels = n_channels
        self.n_classes = n_classes
        self.bilinear = bilinear

        self.incov = DoubleCov(n_channels,64)
        self.down1 = Down(64,128)
        self.down2 = Down(128,256)
        self.down3 = Down(256,512)
        factor = 2 if bilinear else 1
        self.down4 = Down(512,1024//factor)
        self.up1 = (Up(1024, 512 // factor, bilinear))
        self.up2 = (Up(512, 256 // factor, bilinear))
        self.up3 = (Up(256, 128 // factor, bilinear))
        self.up4 = (Up(128, 64, bilinear))
        self.outc = (OutConv(64, n_classes))

     # forward 必须和 __init__ 同级;原来缩进在 __init__ 里面,UNet 实例会没有可用的前向传播。
     def forward(self, x):
        x1 = self.incov(x)
        x2 = self.down1(x1)
        x3 = self.down2(x2)
        x4 = self.down3(x3)
        x5 = self.down4(x4)
        x = self.up1(x5, x4)
        x = self.up2(x, x3)
        x = self.up3(x, x2)
        x = self.up4(x, x1)
        logits = self.outc(x)
        return logits
这里面有个很有意思的模块,就是OutConv,这其实是一个根据需求调整输出的模块,我们会调整out_channels的大小,比如为2的时候,做的就是二类分割,out_channels越多就说明预测的类别数越多。